RAGが変える社内ナレッジ活用|探す時間をゼロにするAI検索
情報を探す時間をなくし、知りたいことにすぐ答えが返ってくる。そんな「社内Google」のような世界を、AIが現実にしつつあります。
そのカギとなるのが RAG です。RAGを活用すると、AIが社内のドキュメントや議事録、チャットログを理解し、文脈に沿った“根拠のある回答”を提示できるようになります。
これにより、特定の人しか知らない情報が組織全体で共有され、ナレッジを基点にした生産性向上が可能になります。本記事では、RAGがどのようにナレッジ活用を支え、実務で“本当に使えるAI活用”へと進化させるのかをわかりやすく解説します。
目次
なぜ今、「RAG」が注目されているのか?
企業の間でAI活用は急速に広がっていますが、「導入しただけで成果につながっていない」という声も少なくありません。資料作成や情報収集といった一部業務では効率化が進んでいるものの、組織全体の生産性に直結する“社内情報の活用”については、まだ道半ばというのが実情です。
特に大きな壁となっているのが、自社データを活用できていないことです。
多くの企業ではChatGPTなどの汎用AIを試験導入していますが、社内のドキュメントやナレッジを参照できないため、回答に根拠がなく、実務で使えるアウトプットを得にくいという課題が生まれています。 つまり、“賢いのに社内では使えないAI”になってしまっているのです。
こうした状況を変える存在として注目されているのが、RAG(Retrieval-Augmented Generation)です。
RAGは社内のナレッジを検索し、その情報をもとに生成AIが“根拠のある回答”を返すことができる、検索と生成を組み合わせたハイブリッド技術です。
RAGを導入することで、AIが社内情報を理解し、事実に基づいた回答を返せるようになります。「社内情報を使えるAI」を実現する中核技術であり、“社内Google”構想を支える仕組みとして導入が進んでいる理由はここにあります。
RAGとは? 仕組みをやさしく解説
RAGは、「検索(Retrieval)」と「生成(Generation)」を組み合わせた技術です。生成AIが社内ドキュメントやFAQ、議事録などの情報を参照し、その内容を根拠に“正確な回答”を返せるようにする仕組みを指します。
従来の生成AIは、質問に対してそれらしい答えを作ることはできても、社内ルールや最新情報に基づいた回答を返すのは難しいという課題がありました。そこで登場したのがRAGです。
RAGは、次の2ステップで動作します。
① 自社データから関連情報を検索(Retrieval)
AIが質問の意図を理解し、社内ドキュメント・FAQ・議事録などから「意味的に近い情報」を検索します。
② 取得した情報をもとに“根拠付きの回答”を生成(Generation)
見つけた情報を踏まえて回答を作成。回答の裏付けとなる出典(参照元)も提示します。
従来の検索との違い
従来の検索 | RAG |
キーワード一致でヒットする情報のみ取得 | 文脈を理解し、意味的に関連する情報を検索 |
情報が「一覧で表示」され、読む必要がある | 必要な情報が整理された「根拠付き回答」で返ってくる |
RAGを業務で活用するには、単に導入すれば良いわけではありません。
ポイントとなる要素は次の3つです。
・精度:関連性の高い情報を取得し、正しい回答を返せること
・信頼性:出典や根拠が提示され、安心して使えること
・運用性:データ更新や改善がしやすく、継続利用できること
つまり、“使えるRAG”とは、正確で、根拠が明確で、継続的に運用できるRAGのことです。
ベクトル検索が支える“文脈理解型”の検索
RAGの根幹を支えている技術が「ベクトル検索」です。従来の検索とは異なり、言葉の意味や文脈の近さで情報を探せる点が大きな特徴です。
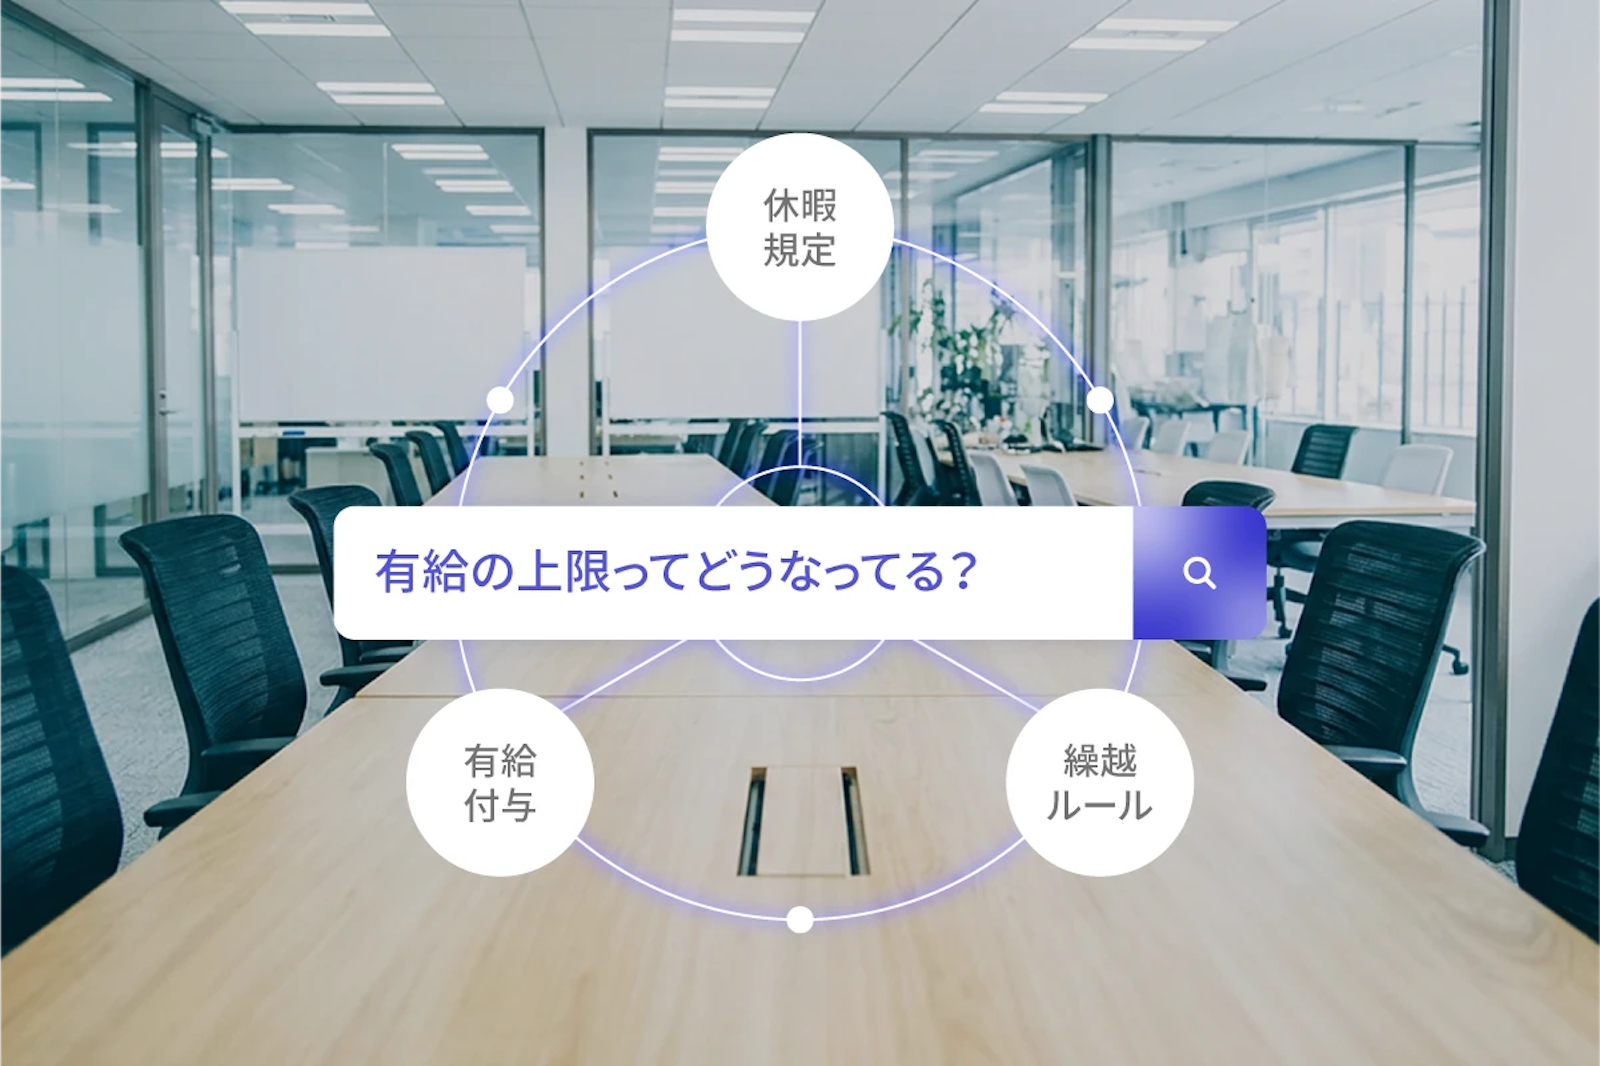
従来の検索は、入力したキーワードと“文字が一致した情報”しかヒットしませんでした。 例えば「休暇 規定」と入力しない限り、有給休暇の情報が見つけづらいといったケースは多くの企業で起きています。
一方、ベクトル検索では、文章を数値(ベクトル)に変換し、“意味の近さ”をもとに検索します。そのため、表現が違っていても関連性の高い情報を見つけることができます。
例:「有給の上限ってどうなってる?」
→ 「休暇規定」「有給付与」「繰越ルール」に関する文書がヒット
つまり、キーワードが一致していなくても、”意図に合った情報”を見つけられる検索体験*が実現できます。自然な文章で検索できるため、検索スキルに左右されない点も大きなメリットです。
このベクトル検索こそが、RAGの回答精度を支えるコア技術です。 “正しく情報を取得できるからこそ”、AIは文脈に沿った根拠ある回答を返すことができます。
RAGがもたらす業務価値
RAGは、社内に蓄積された情報を“活用できる知識”へ変えるための基盤技術です。導入により、次のような効果が期待できます。
・探索時間の削減:必要な情報にすぐ辿り着ける環境を実現
・知識の形式知化:ベテランの暗黙知を共有知として再利用
・部門連携の強化:ナレッジが共通言語となり、意思決定がスムーズに
これまで属人的に扱われていた“個人の知識”を、組織全体で活用できる“組織の知”へ変換できる点こそ、RAGの最大の価値です。
RAGにも複数のタイプがある
一口にRAGと言っても、その仕組みや設計思想はさまざまです。選ぶアプローチによって、運用コスト、精度、そして“どんな企業フェーズにフィットするか”が大きく変わります。ここでは代表的な4つのタイプを整理します。
1. PoC型
NotebookやLLMツールなどで手軽に構築できるタイプです。小規模な検証やアイデア出しをしたい場合に向いていますが、本番運用や継続改善には不向きな傾向にあります。
2. OSS+ベクトルDB型(自前構築型)
柔軟でカスタマイズ性が高い一方、エンジニアによる継続運用が必須となり、属人化リスクが発生しやすいモデルです。技術力のある企業には適していますが、運用負荷は高めです。LangChain × Pinecone 、 Weaviateが当てはまります。
3. クラウドベンダーRAG
安定性がある一方で、業務特化が難しいタイプです。加えて、汎用設計であるがゆえに、一部の日本語処理や業務固有文章の再現に限界があります。Azure や Vertex AIなどが当てはまります。
4. 海外/横展開SaaS型
UIが洗練されているのが特徴です。一方で英語圏向けの設計であるため、日本語の精度や日本企業の業務への対応度は十分と言えません。Notion AIやConfluence などが当てはまります。
RAGが変えるナレッジ活用の3つのポイント
RAGの導入によって、社内の情報活用スタイルは大きく進化します。ここでは、特にインパクトの大きい3つの変化を紹介します。
1. “探しに行く”から“答えが届く”へ
従来は、社内検索で必要な情報を自ら探しに行く必要がありました。RAGを活用すれば、AIが質問の意図を理解し、複数の関連情報を整理したうえで提示してくれます。SlackやTeamsと連携すれば、作業を中断せずに回答を得られるため、“調べる時間”をほぼゼロ化できます。
2. 個人に眠る“暗黙知”が組織の資産に
RAGは、議事録やチャットログなどの非構造データも検索対象にできます。これにより、これまで個人の経験や勘に依存していたノウハウが可視化され、組織全体で再利用できる知識へと変わります。「誰が知っているか」ではなく、「どこにあるか」がすぐ分かる環境が整い、属人化の解消にも直結します。
3. 検索の“民主化”で全員がナレッジ活用できる世界へ
RAGは、専門的な検索スキルがなくても、自然文で質問するだけで必要な情報にアクセスできます。これにより、IT部門だけでなく、営業・人事・製造など全職種が平等にナレッジへアクセスできる状態が実現。部門ごとの情報格差が解消し、ナレッジ活用のハードルが下がります。
業務で“本当に使えるRAG”の条件
RAGの導入で大切なのは、“導入できるRAG”ではなく、“使い続けられるRAG”を選べているかどうかです。実務で価値を生むためには、次の4つがポイントになります。
1. 検索精度
一般的なRAGは、文脈理解が弱く、単語ベースの検索にとどまるケースも多く、ノイズが入りやすい傾向があります。一方、“使えるRAG”は、意味理解や重複排除、要約などを組み合わせ、最も関連性の高い情報をすぐ使える形で提示します。
2. 運用性(メンテナンス負荷)
精度維持のために手動チューニングが必要な設計だと、運用コストが増え、定着の妨げになります。“使えるRAG”は、自動更新や定期評価の仕組みがあり、データ更新や改善の負担が少ないことが特徴です。
3. 継続性(定着する仕組み)
“導入後に使われない”ケースは少なくありません。検索精度や体験にばらつきがあると離脱が起きます。そのため継続利用されるRAGは、フィードバック学習で改善を重ね、使うほど性能が上がる“成長する検索体験”を提供します。
4. セキュリティ
社内情報を扱う以上、権限管理が不十分だとリスクが残ります。“使えるRAG”は、アクセス制御や権限管理に対応し、安心できる環境で利用できることが前提です。
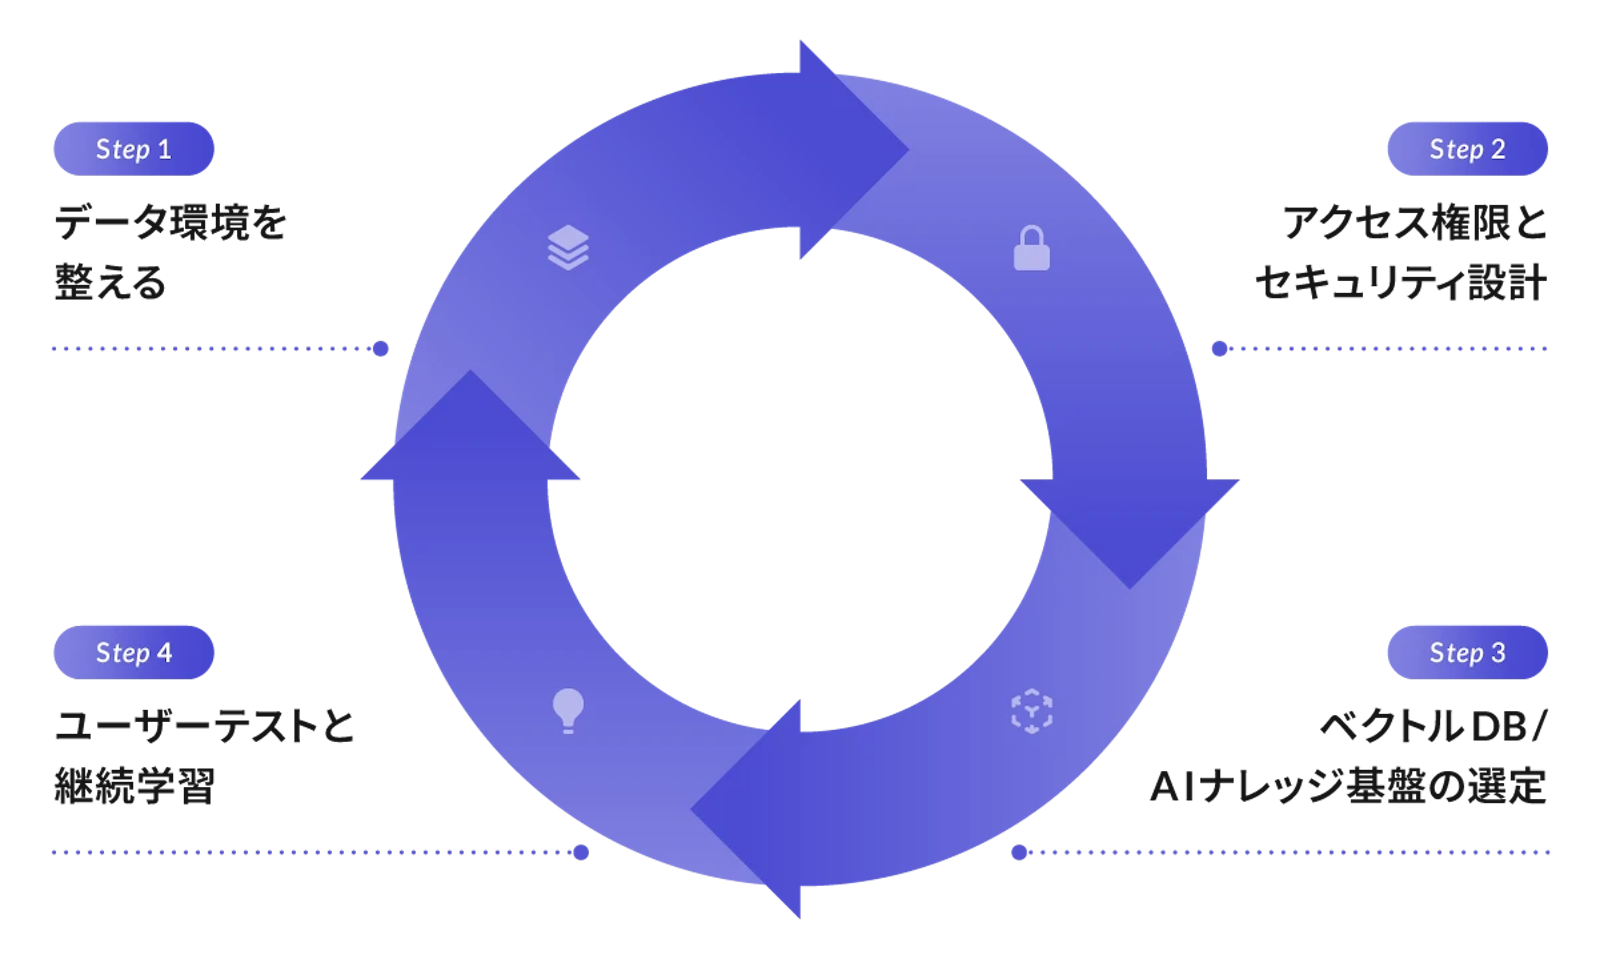
ステップ1:データ環境を整える
まずは、RAGが参照する情報源を整えることが最優先です。ドキュメント、議事録、FAQ、チャットログなど社内に点在する情報を整理・統合し、“検索できる状態”にしておくことが導入の起点になります。
ステップ2:アクセス権限とセキュリティ設計
RAGは社内データを扱うため、認証や権限設計は初期段階で必須です。どの情報を誰が閲覧できるか、アクセス制御やログ管理のルールを定め、安全に活用できる運用基盤を整えます。
ステップ3:ベクトルDB/AIナレッジ基盤の選定
RAGは単体では成立せず、ベクトルDBやAIナレッジ基盤とセットで機能します。自社のデータ形式や利用ツール(SlackやTeamsなど)との連携性、将来的な拡張性などを基準に、自社に適した構成を選定しましょう。
ステップ4:ユーザーテストと継続学習
PoC段階では、実際のユーザーに試してもらい、回答精度や体験を検証します。フィードバックをもとに改善とチューニングを重ね、継続学習によって“成長する検索体験”を構築しましょう。定着後も、利用ログや評価を活用し、精度向上と改善サイクルを回し続けることが成功の鍵です。
まとめ:ナレッジ活用を「RAG」で現実に
RAGは、企業が抱えてきた「情報が散在して見つからない」という課題を、根本から変える技術です。
目指す姿は、誰もが必要な情報にすぐ辿り着ける “社内Google” を実現すること。そのためには、全社で活用できるナレッジ基盤を整えることが欠かせません。
まずは、FAQ、議事録、マニュアル、チャットログなど部門ごとに分断されていた情報を統合し、“保管”ではなく“活用され循環する資産”へと変えることが重要です。さらにRAGによりAIが文脈を理解し、情報同士の関連性を紐づけることで、組織全体が ひとつの知識ネットワークとして機能し始めます。
こうしたRAGによるナレッジ活用を実現できるのが、any株式会社が提供する「Qast(キャスト)」です。QastはSlackやTeamsと連携し、社内ドキュメント・FAQ・議事録を横断検索。根拠付きの回答を返すことで、“探す時間ゼロ”の環境を実現します。
“情報を探す”から“答えが届く”組織へーーまずはQastのデモで、“社内Google”の世界を体験してみてください。
Qastのお問い合わせはこちら(https://qast.jp/contact/)
【参考情報】
・any株式会社:生成AI×RAGで進化するナレッジ活用術
https://qast.jp/resources/wp012/
・any株式会社:RAG徹底比較 ― 業務で本当に使えるRAGとは?